

我在資訊單位的例會上報告昨天那套陷阱池的做法。那批報告是 AI 生成的,陷阱是我設計後請它植入的,評分是另一套 AI 流程跑的。投影片翻到驗證流程那一頁,我講得挺順。
坐在最後面的工程師舉手,問了一句很短的話:
「所以是它自己出題、自己改考卷?」
會議室安靜了兩秒。
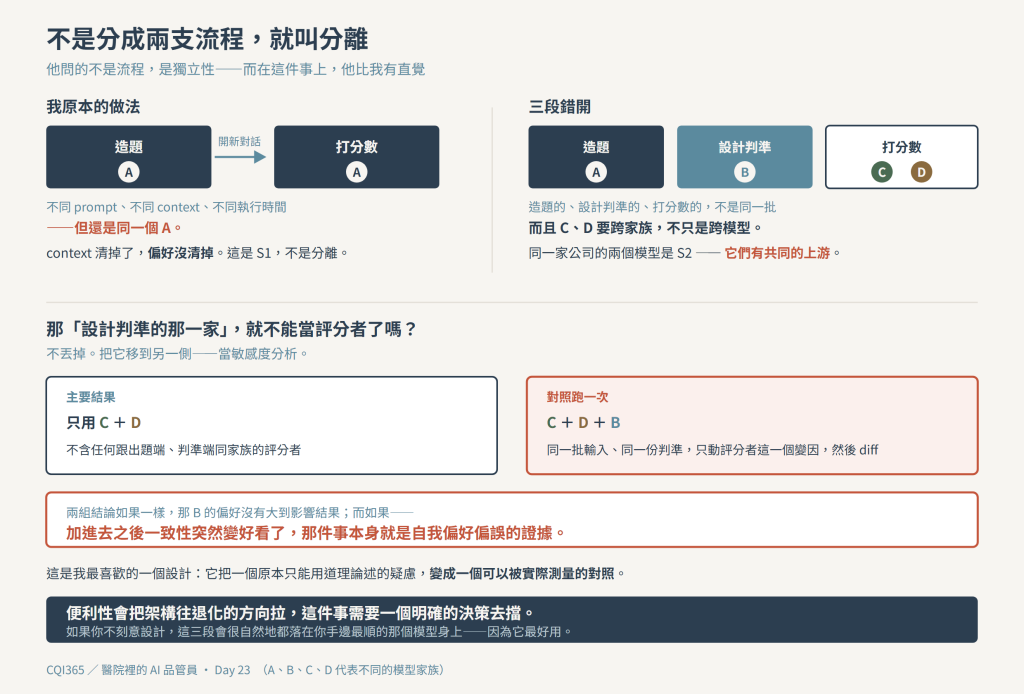
我當下的第一反應是想辯解——不一樣,生成跟評分是分開的兩支流程,不同的 prompt、不同的 context、不同的執行時間。話到嘴邊我停住了,因為我知道他問的不是流程,是獨立性。
而在這件事上,他比我有直覺。他每天在面對的問題是「不要用同一份程式去測自己」,我每天在面對的問題是「稽核員不能稽核自己負責的業務」。是同一條規矩,只是我當時沒有把它套到自己身上。
那次會議之後,「誰來評分」這件事被我從實作細節提升成設計決策。今天講的就是這個決策。
醫院有一套很囉唆的迴避規則。
品管圈成果競賽的評審,不能評自己單位的圈。內部稽核的稽核員,不能去稽核自己平常負責的那條業務。醫院評鑑一定要有外部委員,不是因為院內的人專業不夠,而是因為院內的人對院內的做法有隱性的認同——他看到一個不合常規的流程,第一反應是「我們一向這樣做」,而不是「這樣做對嗎」。
這不是懷疑誰的人品。它假設的是一件更基本的事:評價者跟被評價者之間如果有共享的前提,那評價就會系統性地偏向某一邊,而且偏的人自己不會察覺。
你們有一模一樣的規矩,寫在別的地方:不要 approve 自己的 PR。學術審查有 conflict of interest 揭露。安全稽核要找外部團隊做 pentest。
現在把這條規矩,原封不動套到「用 AI 評 AI」上面。
先講為什麼會走到「讓 AI 評 AI」這一步。
Day 19 談過,這類判斷任務沒有現成的標準答案。Day 20 談過,找人來評的話,人本來就不一致,而且成本高、排不出時間——三位資深委員坐下來看一份報告,那是全院最貴的一段時間。所以「請一個模型來當評分者」不是偷懶,它是目前唯一有機會做到全量、可重跑、每次條件一樣的選項。
問題不在於能不能用 AI 評,而在於用哪一個 AI 評、它跟誰要分開、以及分開之後這個分數可以宣稱什麼。
核心風險有個名字:自我偏好偏誤(self-preference bias)。模型對自己生成的文字,有隱性的偏好。
機制不難想像。同一個模型生成的文本,句式、詞彙密度、段落節奏、論證展開的方式,都落在它自己的分佈中心附近。當它回頭評分,這些特徵會被讀成「流暢」「完整」「有條理」——因為那正是它對「好」的內建定義。
你那邊有一個更乾淨的例子:拿 formatter 自己排版出來的 code 去跑它自己的 linter,永遠零告警。不是因為那份 code 特別好,是因為那份規則檔跟那份輸出,本來就是同一套假設的兩個面向。
於是你以為你在量報告的方法論品質,其實你在量的是別的東西:
我以為我在量報告的品質,其實我在量的是模型認不認得自己的字跡。
這件事的殺傷力在於它不會失敗得很難看。你不會拿到一堆離譜的分數然後警覺,你會拿到一組看起來很漂亮、一致性很高的結果——而高一致性正好是你想要的東西,所以你不會質疑它。
「分開」不是一個是非題,是一個尺度。我後來把它整理成四層,因為第二層跟第三層之間那條線,是我原本沒有畫對的地方。
| 層級 | 做法 | 判定 |
|---|---|---|
| S0 | 同一次對話、同一段 context 裡生成完再評 | 明顯不行。它記得自己剛寫了什麼 |
| S1 | 開新對話,但同一個模型 | 還是不行。context 清掉了,偏好沒清掉 |
| S2 | 同一家公司的不同模型 | 也要當成有污染風險 |
| S3 | 不同家族的模型 | 這才是主線 |
這四層在你那邊也不是新東西:同一個 process 裡跑的 test、同一台機器上跑的 test、同一個 base image 建出來的兩條 CI——每往外推一層,你排除掉的共同失效就多一類。而大家通常只推到第二層就停了。
S0 跟 S1 大部分人會同意。真正需要解釋的是 S2。
同一家公司的不同模型——比方說同一個家族裡的大模型跟小模型——為什麼也要當成不獨立?因為它們共享的東西比你以為的多:大量重疊的訓練語料、同一套偏好對齊的取向、同一組內部的風格慣例。
用相依的話講:**它們有共同的上游。**你 pin 了兩個不同的套件版本,但它們依賴同一個底層函式庫——那個函式庫壞掉,兩個一起壞,而你的 test 兩條都綠。它們對「什麼叫寫得好」「什麼叫論證完整」的先驗是相關的。
這件事在醫院有一個現成的對照:請同一個科的兩位資深醫師互評,他們的分歧一定比跨科的兩位小。但那個「小」不是因為他們判斷比較準,是因為受的訓練、讀的指引、平常討論的對象是同一批。院內稽核要找外部委員,防的就是這個。
用統計的話講:這兩個評分者不是獨立的觀測。 你把它們之間的一致性當成信度指標,會系統性地高估。你以為你有兩個評審,其實你有一個評審加一個很像他的人。
那把同家族的模型丟掉嗎?不。更好的做法是把它留下來當敏感度分析:
如果加進去之後一致性突然變好看了,那件事本身就是自我偏好偏誤的證據。
形式上它就是一次對照跑:同一批輸入、同一份判準,只動評分者這一個變因,然後 diff 兩邊的結論。 這是我最喜歡的一個設計——它把一個原本只能用道理論述的疑慮,變成一個可以被實際測量的對照。
這跟品質委員會那句「有疑慮就去量」是同一個習慣:一個說不清楚的擔心,在會議上永遠吵不完;變成一個跑得出來的對照之後,下次開會拿出來的是數字,不是立場。
S2 那條線還算好畫。真正隱蔽的是這一個。
Day 21 談過錨點設計——把評分標準寫成 prompt 裡可判定的敘述。其中措辭迭代的部分,我曾和某個模型來回測試:我寫一版,丟給它讓它照著評,看它理解錯哪裡,回來改措辭,再丟一次。磨了很多輪。這是在測試文字怎麼被模型解讀;正式判準仍需要相關專業共同確認。
結果就是,那份 prompt 的每一個字,都是朝著「這個模型讀得懂」的方向收斂的。
那如果讓它來當主要評分者呢?它會考得特別好。但那不是能力,是主場優勢。題目是照著它的理解方式出的。
這跟同一個人既寫 spec 又寫 test 是一樣的:test 一定會過,因為它們是同一個理解的兩個投影。過了不代表東西對,只代表這兩份文件沒有互相矛盾。
設計者不能同時是被評估者。這在品管叫利益迴避,在工程上叫不要用同一份程式測自己。
所以最後的分工是三段全部錯開:造題的、設計判準的、打分數的,不是同一批。 這聽起來很基本,但它不是自然發生的——如果你不刻意設計,這三件事會很自然地都落在你手邊最順的那個模型身上,因為它最好用。就像所有的邏輯最後都會長進 repo 裡同一包那樣——不是有人決定要這樣,是沒有人決定不要這樣。
醫院擋這件事的方式很笨但有效:迴避規則寫進辦法裡,評審名單送品質委員會核定,不是誰有空誰評。笨在它很囉唆,有效在它不依賴任何人當下的自覺。
便利性會把架構往退化的方向拉,這件事需要一個明確的決策去擋。
分離解決的是獨立性,還有一個問題它解決不了:一個評分者給的分數,你分不出「這份報告不好」跟「這個評分者這樣看」。
所以評分者要有好幾個,而且要各自獨立地評、彼此看不到對方的輸出。這在人的共識會議也是同一條規矩——先各自打分,再開會討論歧異,不能先聽到別人怎麼講。品管圈成果發表那天,評審是先各自在評分表上打完才進討論室的,不是邊聽邊打;而那個順序是委員會訂的,不是評審自己想的。順序反過來,你量到的就是誰講話比較大聲。
多評分者真正的價值不在於平均分數比較準,而在於它讓不一致變成可觀測的訊號。而這個訊號指向的地方跟直覺相反:幾個獨立的模型對同一個維度給出分歧的分數,最省事的解讀是「模型還不夠強」,但更常見的答案是另一個——那個維度的定義寫得不夠清楚。
不同架構、不同訓練資料的模型,如果都能收斂到相近的分數,那代表這個維度的定義夠明確,明確到不同的「讀者」讀出來的意思是一樣的。反過來,如果某一個維度上大家散得很開,通常不是模型的問題,是我的判準在那一格留了太多解釋空間。
多模型一致性低的時候,第一個該被檢討的不是模型,是我的判準。
同一批圈報告,七個維度上大家都收斂,只有一個維度散得很開——那一格就是我留了太多解釋空間的地方。而這跟 Day 20 那場共識會議的結論一模一樣:那天下午我們沒有改分數,改的是評分表。
這是我在整個驗證階段收穫最大的一句。它把一致性指標從「技術指標」翻轉成「方法論品質指標」——量的不是模型有多強,是我的規格書寫得有多清楚。信度指標的意義 Day 20 談過,這裡是它換了個用途。
用你們的話講:幾個資深工程師讀同一份 spec,實作出來的東西差很多,第一個要修的通常是 spec。
一、寬鬆漂移。 模型當評分者的時候,分數會往中間偏上跑。五分制上「大概三分半到四分」是它的舒適區——那裡最安全,聽起來最像一個公允的專業意見。方向是穩定的:它偏向給「還不錯」。 所以陣容再獨立,如果沒有錨點把每一分的意思釘死(Day 21),也沒有陷阱池去校準「該低的時候有沒有低」(Day 22),你會得到一組非常一致、而且一致地偏高的分數。一致而且一致地錯,在監控上就是那種永遠不會觸發的 alert——它每天都在跑,每天都是綠的,而你從它身上得不到任何資訊。
二、順序與篇幅。 兩份東西並排讓它比較,先後順序會影響結果;比較長的那一份容易被評高。這兩件事在我們的場景會直接把結果帶歪,因為報告的長度跟方法論品質根本沒有關係。設計上的處理很單純:不做兩兩比較,每一份獨立打絕對分數,而且評分時不讓它看到其他報告。這跟「test 之間不能有順序相依」是同一條規矩——一旦 A 的結果會影響 B,你就不能只重跑 B。少了比較的參照,它只能回去讀錨點——那正是我要的。
三、理由與分數脫鉤。 這一種最需要警覺。它輸出的理由段落裡清楚寫了幾個嚴重問題,分數欄位卻很體面。人讀完那段理由就相信它懂了,不會回頭核對分數。這跟 Day 22 在陷阱池上看到的是同一個東西,只是換了個位置出現:理由跟分數是兩個要互相檢核的輸出,不是一個輸出加一段裝飾。
實務上把它做成一條硬規則:理由裡出現嚴重缺陷的描述、分數卻在高分區,這一筆自動標記送人審。這條規則不修模型,修的是流程——在系統會壞的地方放一個看得見它壞掉的裝置,這是 Day 16 談偵測性時的老話。
四、一個實務限制順帶變成了架構優勢。 Day 5 講過,敏感資料只走地端模型。所以評分陣容裡本來就必須有一個跑在院內機器上的模型,沒得選。這原本是個限制,但它剛好增加了陣容的架構多樣性——地端模型跟雲端那幾個在訓練與規模上差得夠遠,反而是這組評分者裡最不容易跟別人共謀的一個。
最後一件很不浪漫但很重要的事:評分者陣容是一個版本化的物件。
哪幾個模型、各自什麼版本、什麼參數、配哪一版 prompt、每份跑幾次取共識——這一整組要記在同一個地方,跟結果一起存。只要換掉其中任何一項,前後兩批分數就不能直接比。
換掉一個評分者等於換掉一位評審。你不會在品管圈競賽評到一半換人,然後說分數還是可比的。這件事在 AI 這一側太容易發生了,因為「換個模型試試」的成本低到幾乎沒有感覺——而正是這種沒有感覺的變更最傷。版本控管那一套怎麼落地,Day 27 專門談。


 iThome鐵人賽
 看影片追技術